2026年10月14日,德国达姆施塔特工业大学语言文学研究所马尔库斯·穆勒(Marcus Müller)教授应邀到访同济大学德语系,在汇文楼518作了题为“自然意义与人工智能——从语料库语言学视角看专业语义与日常语义的区分”的学术讲座。讲座以国际关系术语研究为案例,介绍了语料库语言学与人工智能相结合的研究方法。讲座由德语系副主任李莎莎副教授主持。
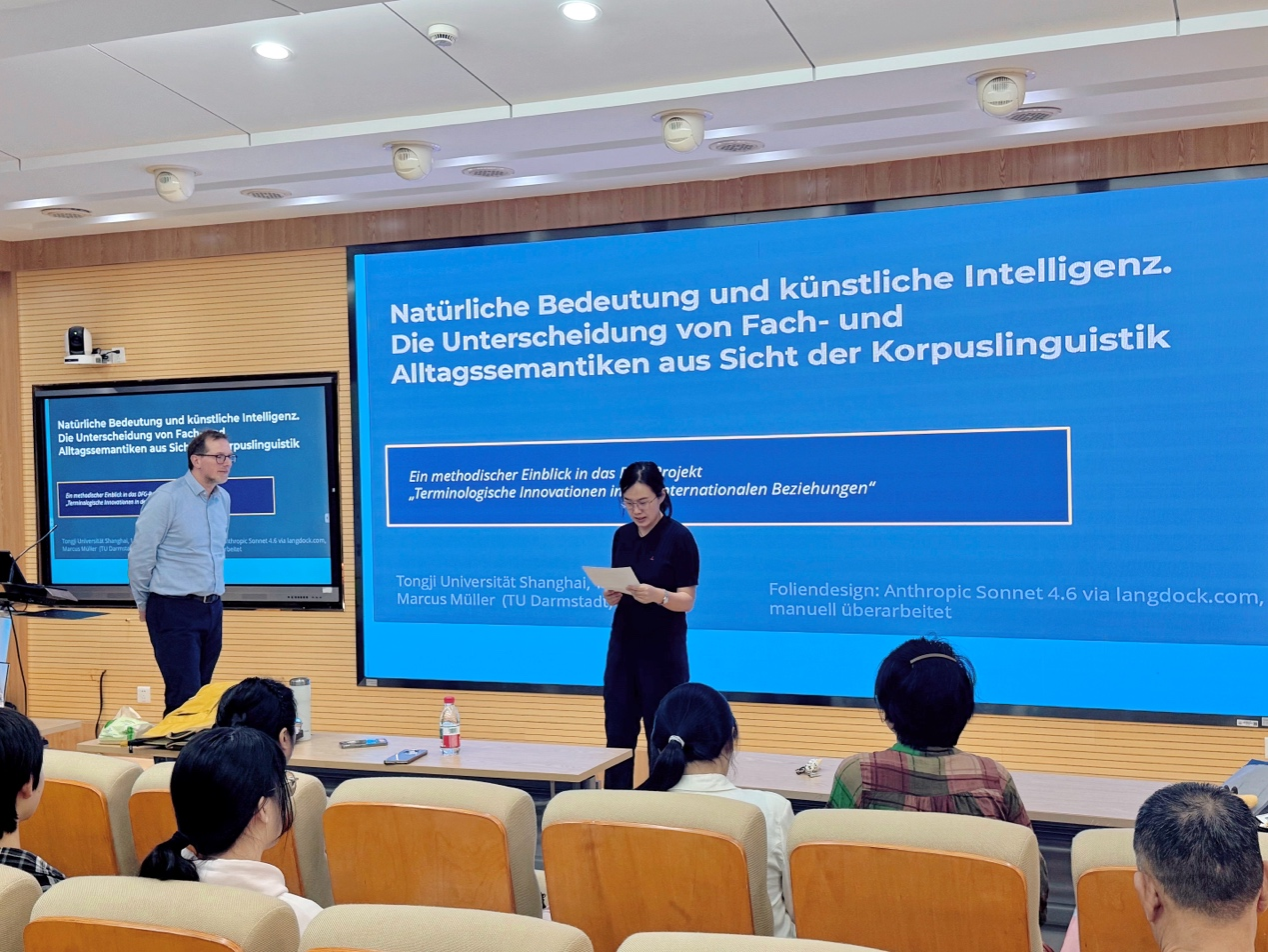
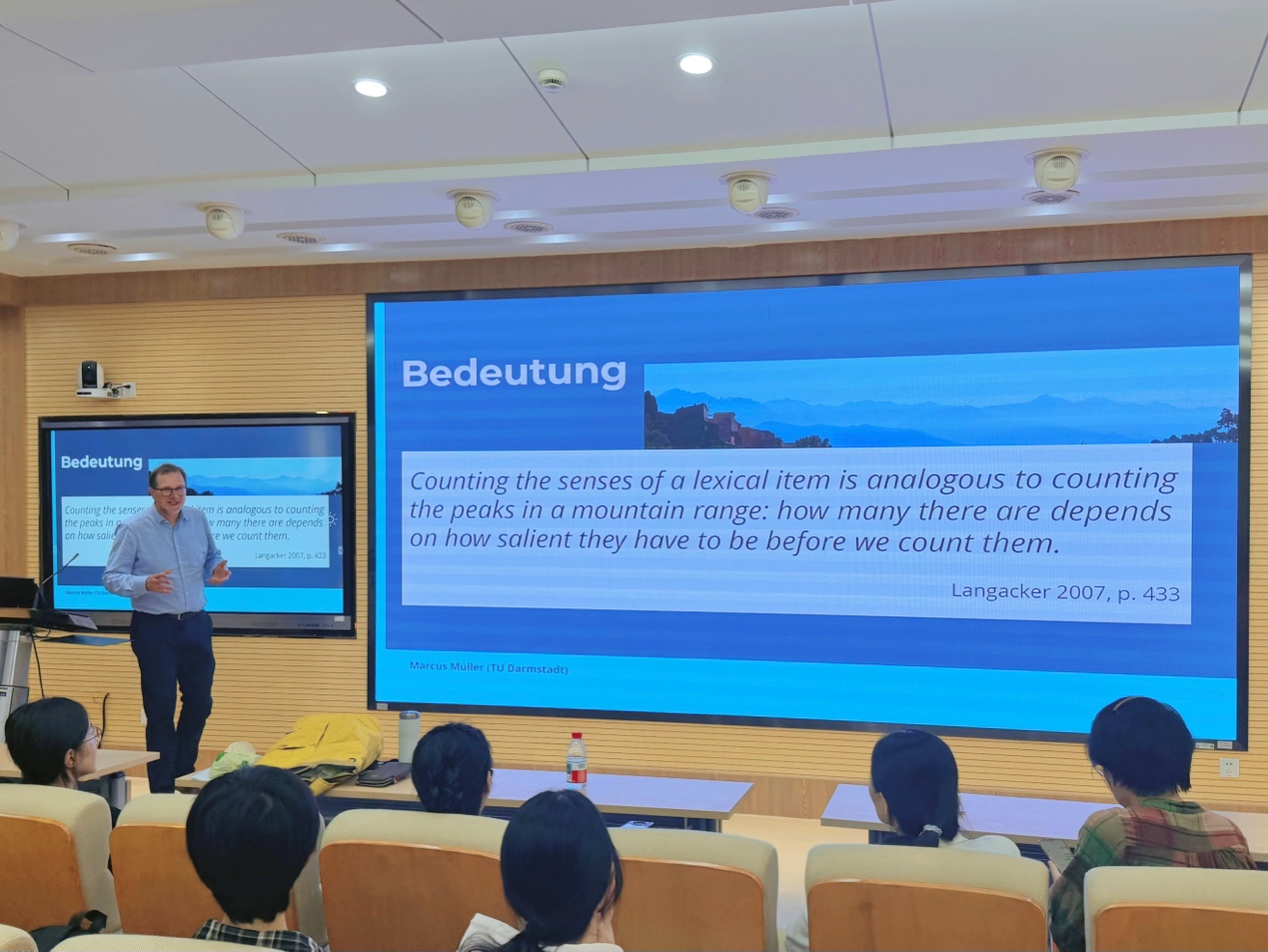
穆勒教授首先从词义的欠规定性、模糊性与歧义性谈起。他以“数山峰”为喻指出,词义之间并不总有清晰的分界,研究者采用不同的划分标准,可能得到不同的结果。德语词汇 Schnecke 在不同语境中可以指蜗牛、提琴的琴头或一种糕点;Regime 在日常语言与国际关系研究中也有不同用法。这些例子说明,判断词义必须回到具体语境。由此,穆勒教授引出了词义消歧问题,并梳理了相关技术从规则方法、统计机器学习到BERT和大语言模型的发展。
随后,穆勒教授介绍了由德国科学基金会资助的国际关系术语研究项目。项目建立的TIIB语料库收录了1976年至2000年间的24,235篇文本、约2,590万词次,涵盖学术研究、政策咨询与政治实践三个领域。研究团队以“合作”“干预”“整合”“规范”“机制”“缓和”等术语为对象,考察专业概念在不同领域中的使用及其意义变化。穆勒教授还谈到,部分早期政策咨询材料仅存于纸质文献中,语料建设需要经过拍摄、文字识别和反复校对。
在语义标注环节,研究团队先由两名标注者独立判断词语是否具有国际关系领域的专业含义,再对判断不一致的例子进行专家复核。穆勒教授指出,人工判断存在分歧,有时正是因为概念本身具有复杂的边界。团队进一步比较了不同提示词和模型的标注表现,并介绍了基于EuroBERT-610M微调的T-EBERT模型。实验显示,明确给出词义定义有助于改善标注效果;选择模型时,也需要同时考虑性能、使用成本、结果的可复现性与可解释性。
穆勒教授还通过具体例子分析了模型出错的原因:模型可能选错概念框架,也可能识别了正确框架,却误判其中的参与者;重复运行时,判断结果还可能不一致。讲座最后,他展示了部分术语在三类语料中的变化趋势,并提醒,图表中的峰值有时仅由少数文章造成,需要回到原文解释数据。
穆勒教授强调,清晰的标注规则是有效使用人工智能的前提,领域专家的核查与解释同样不可缺少。模型的错误并非只意味着技术失效,也可能提示研究者重新审视概念的适用边界。讲座通过从语义问题到语料建设、模型实验和结果解释的完整案例,展现了跨学科研究如何借助人工智能推进专业语义分析。
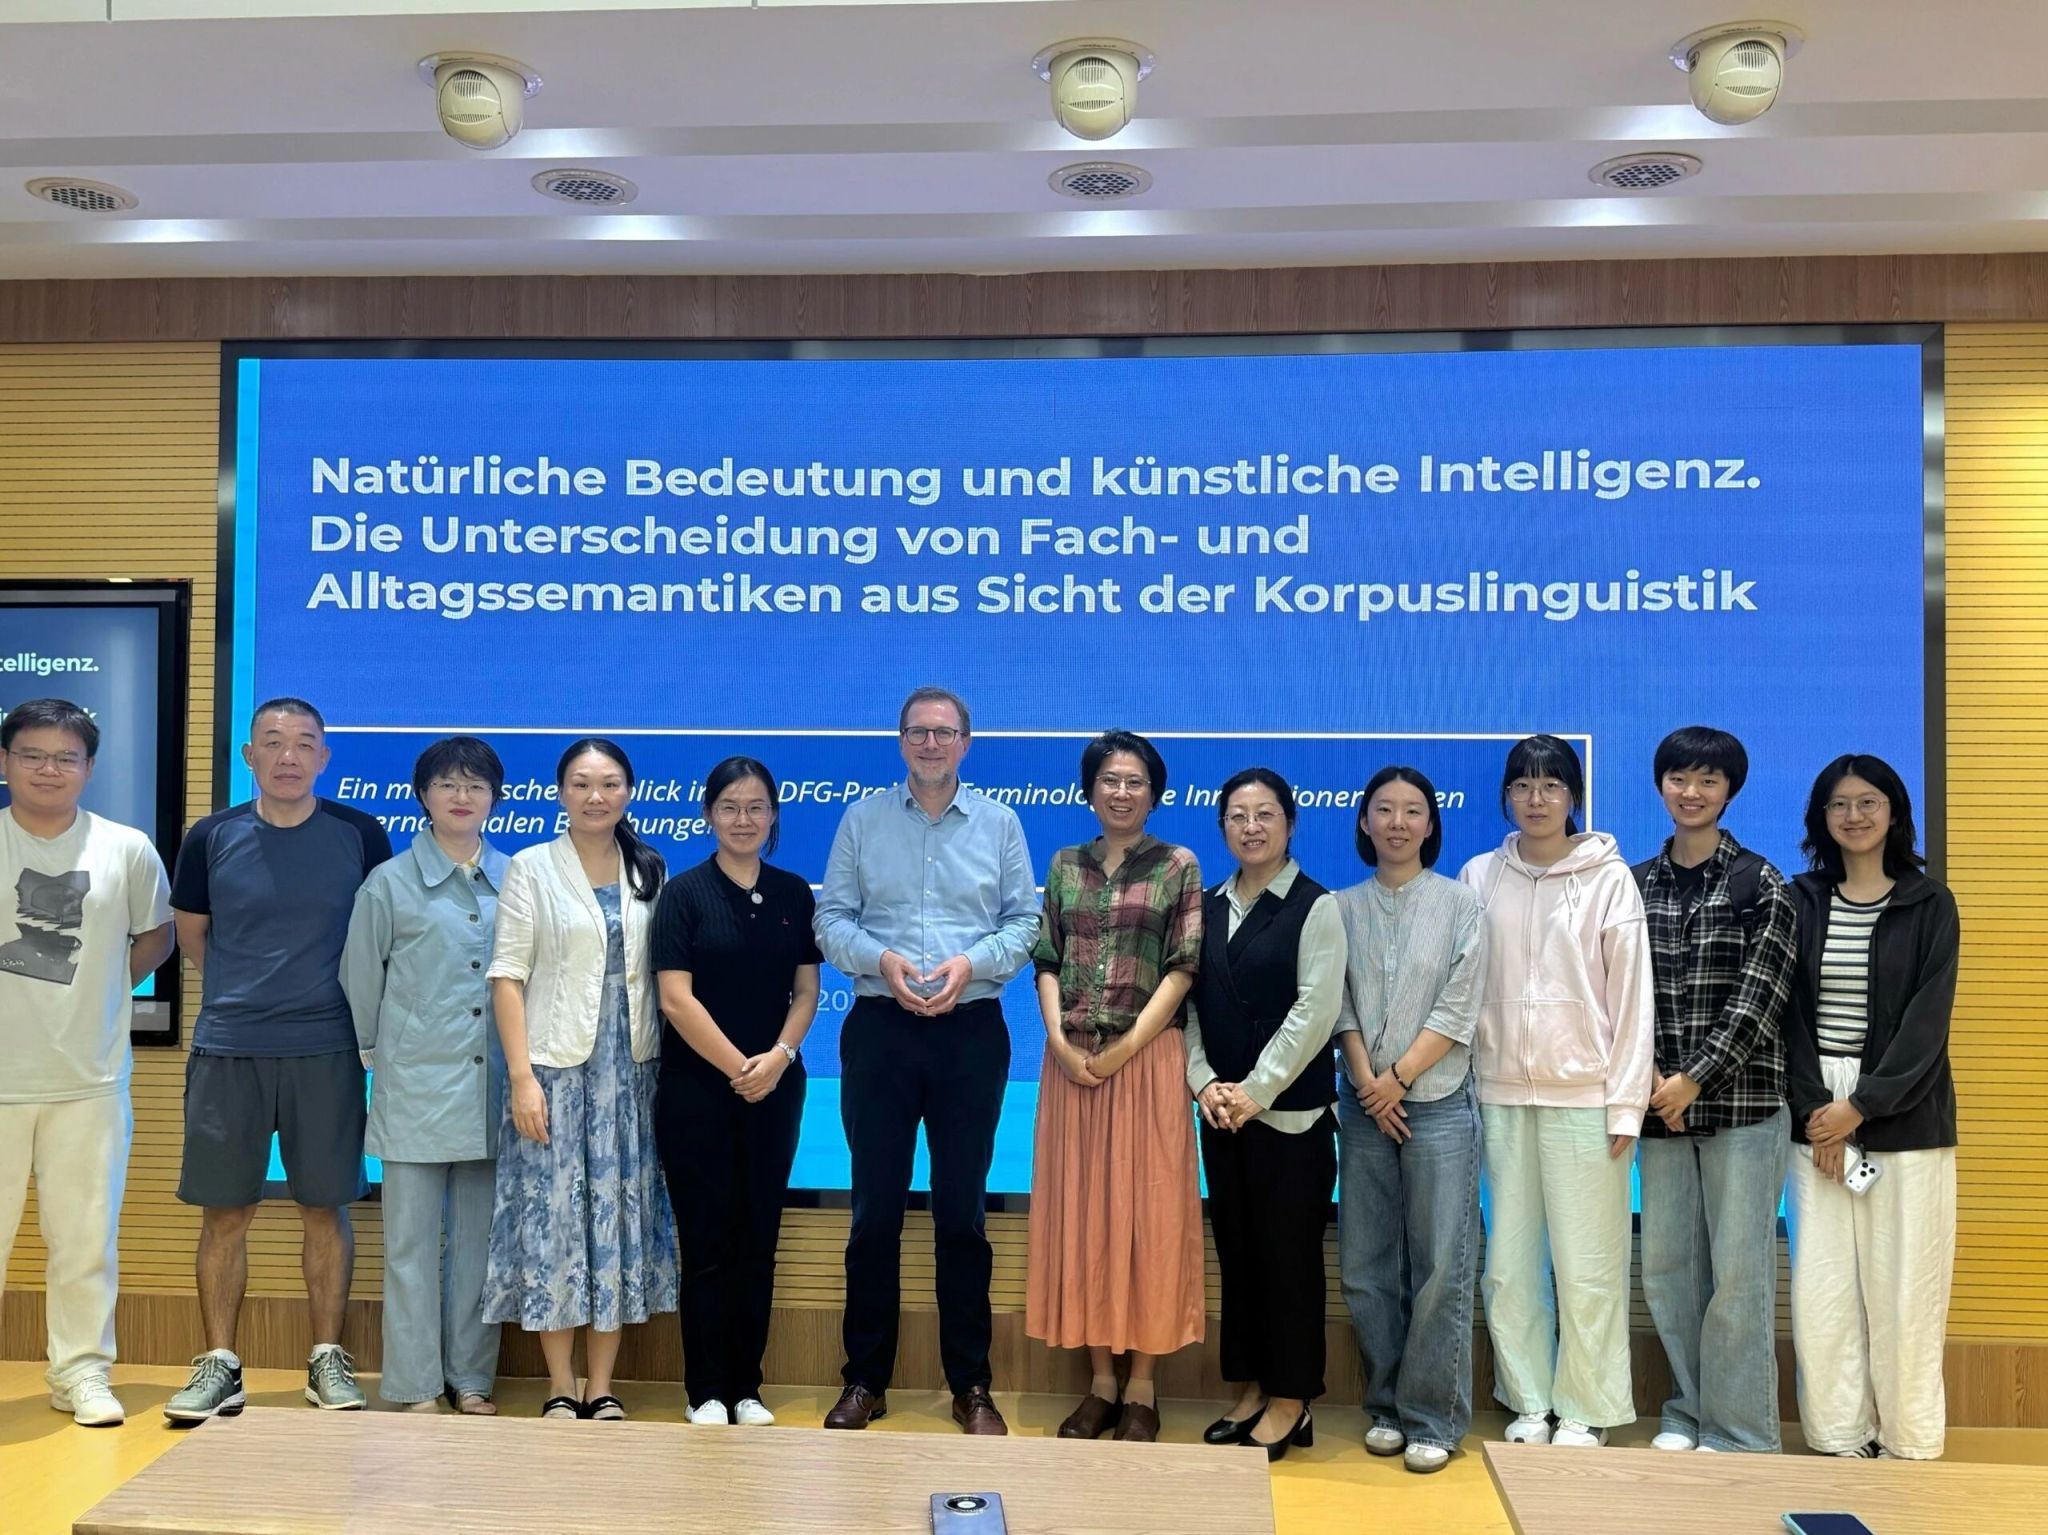
讲座结束后,现场师生就语料库构建、模型可解释性、多义术语标注难点等问题,与穆勒教授展开了进一步热烈讨论。


 DE

